
OpenAI倒了座“屎山” 数学家捏着鼻子在里面淘金
来源:倍可亲(backchina.com)今年夏天,王虹因为挂谷猜想的三维版本拿了菲尔兹奖。不到3个月,OpenAI说它的AI把四维版本也解决了。
10月7日,美国OpenAI公司在代码托管网站GitHub上一口气放出了722篇数学手稿。
它们出自同一个从未公开的内部模型,覆盖数论、几何、概率、理论计算机等17个数学分支。OpenAI说,模型一共尝试了约4000个悬而未决的数学问题,最后在372组问题上拿出了结果。平均每个结果耗费的算力,大约相当于ChatGPT付费高级版思考3个小时。
其中一项,被一位数学家评价为:如果是人做出来的,“立刻拿菲尔兹奖,没有任何疑问”。菲尔兹奖是数学界的最高荣誉,4年才颁一次。
OpenAI一口气放出了722篇数学手稿丨AI生图
可这722篇手稿,到现在还没有谁通读过一遍,OpenAI自己的研究人员也没有。
光是目录加摘要就有大约40页,有数学家从头翻到尾,花了大半个小时。接下来几天,各个方向的专家翻看自己熟悉领域的那几篇,陆续带出了坏消息:有的证明错了,有的根本读不懂,有的连机器检查都没做过。
有数学家形容,这是一大坨屎被倒在了自家门口。
偏偏这堆屎山里,很可能真有金子。
手稿里最好懂的,是平面染色问题。
给一张无限大平面上的每个点涂颜色,随便定一个长度当作1,要求任意两个相距恰好为1的点颜色不同,最少需要几种颜色?
这个问题1950年就有人提出,之后几十年,人们只知道答案在4到7之间。2018年,英国一位研究抗衰老的生物学家、业余数学家奥布里·德格雷(Aubrey de Grey)证明至少要5种。
这次OpenAI的模型声称,5种也不够,答案只剩6或7。
分量最重的一项和黎曼猜想有关。
素数,也就是只能被1和自身整除的数,在数轴上分布得看似杂乱,背后却被一个叫黎曼ζ函数的东西控制着。这个函数有无穷多个零点,也就是让函数值等于0的位置,它们的排布决定了素数的排布。
数学家已经知道,除了一批位置早就清楚的零点,其余的全都落在一条带子里,用数学语言说,它们的实部在0到1之间。1859年,德国数学家黎曼猜测,它们其实整整齐齐排在带子正中那条线上,实部都等于1/2。
160多年过去,黎曼猜想没人证得出来,连退一大步的弱化版本也没人做到。只要能证明带子右边某一截完全没有零点就算成功,哪怕只是0.99到1之间那一窄条,人类也证不出来。
这次的手稿声称,实部大于7/8的区域里一个零点也没有。
美国罗格斯大学的数学家亚历克斯·孔托罗维奇(Alex Kontorovich)说的“立刻拿菲尔兹奖”,指的就是这一项。
这离黎曼猜想本身还差得远。猜想要的是1/2,美国佐治亚理工学院的马特·贝克(Matt Baker)提醒,完整证明可能需要完全不同的方法。
况且,这些结果眼下都还只是手稿上的声称。722篇手稿没有一篇经过同行评审,也没有人类作者署名。
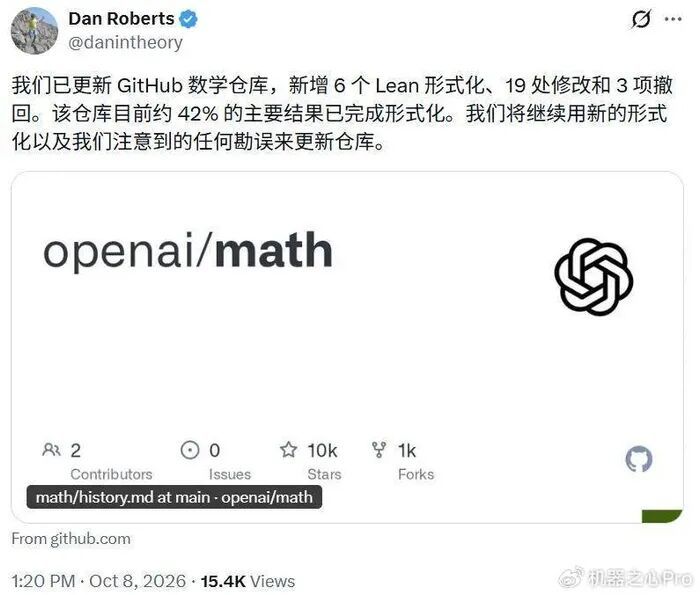
第2天,OpenAI就撤回了3篇论文丨X截图
发布第2天,OpenAI就撤回了3篇。毛病出在第一篇里的一个符号上:该写负号的地方写成了正号,一步关键的抵消因此不成立。另外两篇建立在同一个构造上,跟着一起撤回。同一天,还有14篇做了修补。
更多的稿子,毛病出在读不懂。
美国布朗大学的布伦丹·哈塞特(Brendan Hassett)翻开自己最熟悉的那个问题,粗读一遍,觉得不知所云。他说,这要是人写的,他不会再多花时间,可后面还有721篇。
美国普林斯顿大学研究黑洞数学的米哈利斯·达费莫斯(Mihalis Dafermos)看了自己领域的几篇,挑不出具体哪里错了。它们写得太含糊,够不上证明的标准,连错都谈不上。
读不懂的证明,本来还可以交给机器。
数学有个别的学科没有的便利:证明可以翻译成Lean这类程序能读懂的语言,由计算机逐行检查。截至10月10日,约42%的结果通过了这种机器检查。其余的那些,OpenAI在说明文件里也承认可能有问题,撤回的3篇就在其中。
机器检查也有盲区。程序只能保证它拿到的那句话被证明了,这句话和论文里的原题是不是一回事,还得有人去读代码核对。负责Lean数学库的约翰·科梅林(Johan Commelin)就怀疑,有些形式化版本证明的其实是更弱的命题。
这几天翻稿子的数学家里,已经有人发现,机器验证过的那句话和论文里宣称的结论,看上去并不总能对上。
这样一来,哪篇是金子,哪篇是烂稿,只能靠人一篇一篇去读。
这个活儿,落到了整个数学界头上。
英国牛津大学的厄休拉·马丁(Ursula Martin)说,OpenAI这是扔给学界一份乱糟糟的初稿,再指望别人替它收拾。
放在过去,把证明讲明白,是拿出证明的人自己的事。
菲尔兹奖得主陶哲轩讲过数学界的惯例:一个长期难题被攻克后,证明者会到处做报告,同行组织研讨班一起啃,新的合作和新问题随之冒出来,年轻人被吸引进这个领域,证明被一步步简化,最后写进教科书。
现在,难题被AI成批解掉,提交结果的人自己也讲不清楚,这一连串反应几乎不再发生。研究者还开始把有前途的方向藏起来,生怕被抢先。陶哲轩把这比作露天开矿,把未解问题一片一片挖光。
有人干脆不接这个活。发布第2天,一个由800多名数学家组成的团体“人类数学协会”发表声明,呼吁同行停止与OpenAI合作。声明说,一次放出700多个文件,是在秀肌肉,算不上学术。
开口批评的不止这一个团体。9月,20多位菲尔兹奖得主就联名发表过宣言,批评AI公司把数学难题当成测试模型的考题。
他们担心的是答案背后的东西。数学家攻一道难题,路上会造出新方法,再靠报告、讨论和教科书传给后来的人。AI直接把答案端出来,没人消化,这些方法就传不下去。
年轻人已经先吃了亏。博士论文、经费申请、求职材料,往往就押在某一个未解问题上。手稿放出来之后,有数学家说,身边一批朋友和同事的经费申请一夜之间作废了。还有人担心,下一代要是不再啃难题,几十年后,这些数学可能就没人看得懂了。
数学界并没有达成一致。加拿大多伦多大学的丹尼尔·利特(Daniel Litt)认为,这对数学是好事,他转述一位合作者的感受:“我觉得自己爬了一辈子,现在能飞了。”也有人看到自己研究过的问题被解决,感到的是轻松。
兴奋也好,愤怒也好,摆在所有人面前的是同一堆稿子。数学家普遍估计,把这722篇弄明白,要花好几年。
OpenAI没有停下的意思。它表示会继续拿数学问题测试自己的内部模型,数学圈里也已经在传下一批手稿。
法国国家科学研究中心(CNRS)的数学家斯科特·阿姆斯特朗(Scott Armstrong)自认是对AI最乐观的那批人之一。被问到接下来的打算,他说眼下最要紧的是把手头的研究做完,“趁OpenAI还没抢在我们前面”。
版权说明 / Copyright Notice:Content and images in this article may originate from third-party sources and are used for news reporting, commentary, or public interest purposes. All copyrights remain with their respective owners. Please refer to the Copyright Notice at the bottom of this page.
本文内容仅供信息参考,不代表倍可亲立场或观点。
评论 (0)